№ 0818Reddit post
Glimmer on a $135 MI50 + RX 7900 GRE rig
Benchmarked ~20 GGUF models on a dual Radeon MI50 16GB + RX 7900 GRE Vulkan setup; Muse Glimmer 30B UD-Q6_K_XL posted ~248 tok/s pp512 and ~17.4 tok/s tg128.
Dual AMD Radeon MI50 16GB and RX 7900 GRE 16GB VRAM Vulkan benchmarks
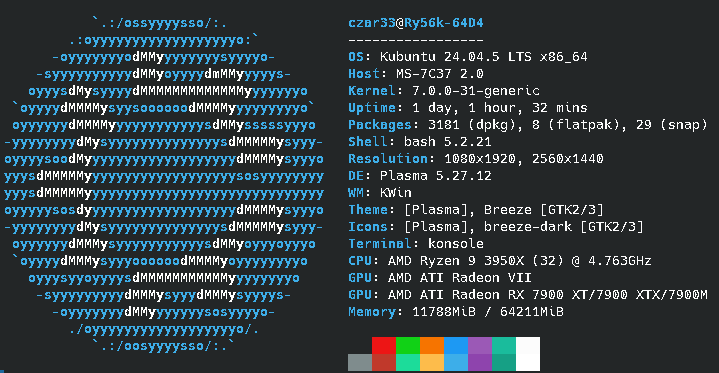
Picked up China version of the Mi50 (Radeon VII) 16GB VRAM GPU for about $135. Ran it using llama.cpp Ubuntu Vulkan prebuilt binary build: b29c606e2 (10964). Used a Power Limit or 220/190 watts on the GPUs. Dual Radeon 32GB Vram and 64GB DDR4 System Dual Radeon RX 7900 GRE and Radeon VII 32gb VRAM GGUF Models: • Qwen3.6-35B-A3B-UD-Q5_K_XL.gguf • Accio-Lab_occamy-1.0-Q5_K_S.gguf • Laguna-XS-2.1-APEX-I-Balanced.gguf • NVIDIA-Nemotron-3.5-Lightning-30B-A3B-Q5_K_M.gguf • Gemma-4-31B-it-Q6_K.gguf • Ateron_Gemma-4-MoonGem-31B-Q5_K_M.gguf • Qwen3-Coder-30B-A3B-Instruct-UD-Q6_K_XL.gguf • Qwen3-VL-30B-A3B-Thinking-UD-Q6_K_XL.gguf • Qwen3-Coder-30B-A3B-Instruct-UD-Q5_K_XL.gguf • North-Mini-Code-1.0-MXFP4_MOE.gguf • GLM-4.7-Flash-Uncen-Hrt-NEO-CODE-MAX-imat-D_AU-Q6_K.gguf • Muse-Glimmer-30B-UD-Q6_K_XL.gguf • Huihui-Qwen3.8-27B-abliterated-UD-Q6_K_XL.gguf • Qwen3.8-27B-Q6_K.gguf • Qwen3.8-27B-OBLITERATED-Q5_K_M.gguf • Medgemma-27b-it-UD-Q6_K_XL.gguf • Gemma-4-26B-A4B-it-UD-Q6_K_XL.gguf • Gemma4-26B-A4B-QAT-Uncensored-HauhauCS-Balanced-Q4_K_M.gguf • GPT-OSS-20b-abliterated.i1-Q6_K.gguf Sorted by params then size model size params pp512 tg128 qwen35moe 35B.A3B Q5_K - Medium 24.76 GiB 3



 ChatForm
 Tgmlabs